生成AIの脆弱性と聞くと、ソフトの欠陥に修正プログラム(パッチ)を当てる話を思い浮かべるかもしれません。ただ、生成AIの脆弱性には、パッチを当てても完全には直らない弱点が含まれます。AIが文章を処理する仕組みそのものに由来するためです。検索結果には、AIが他のソフトの脆弱性を見つけたという報道も並び、この言葉が何を指すのかも分かりにくくなっています。この記事では、セキュリティの国際的な非営利団体OWASPが公開する「LLMアプリケーションのトップ10(2025年版)」をもとに、生成AIの脆弱性が指す3つの意味、従来の脆弱性との違い、LLM(大規模言語モデル)特有のリスク、そして生成AIを組み込んだシステムを開発会社に頼むときの確認点を、発注者の目線で整理します。
この記事のポイント
- 生成AIの脆弱性は、周りのシステムの欠陥、モデルの性質に由来する弱点、データと権限の設計の不備という3つの層に分けて見ると、誰が直すのかが決まる
- プロンプトの処理に由来する弱点は、RAGや追加学習でも完全には軽減できないとOWASPは説明しており、パッチを当てて終わりにはならない
- LLM特有のリスクは、指示の乗っ取り、情報の出すぎ、権限の与えすぎ、出力の扱い、部品とデータの出どころ、誤情報と使いすぎの6つの入口にまとめられる
- 発注では、AIに持たせる権限、渡すデータの範囲、出力の検証、納品後の確認の仕組みを、開発会社に書面で確認する
目次
生成AIの脆弱性は従来の脆弱性と何が違うか
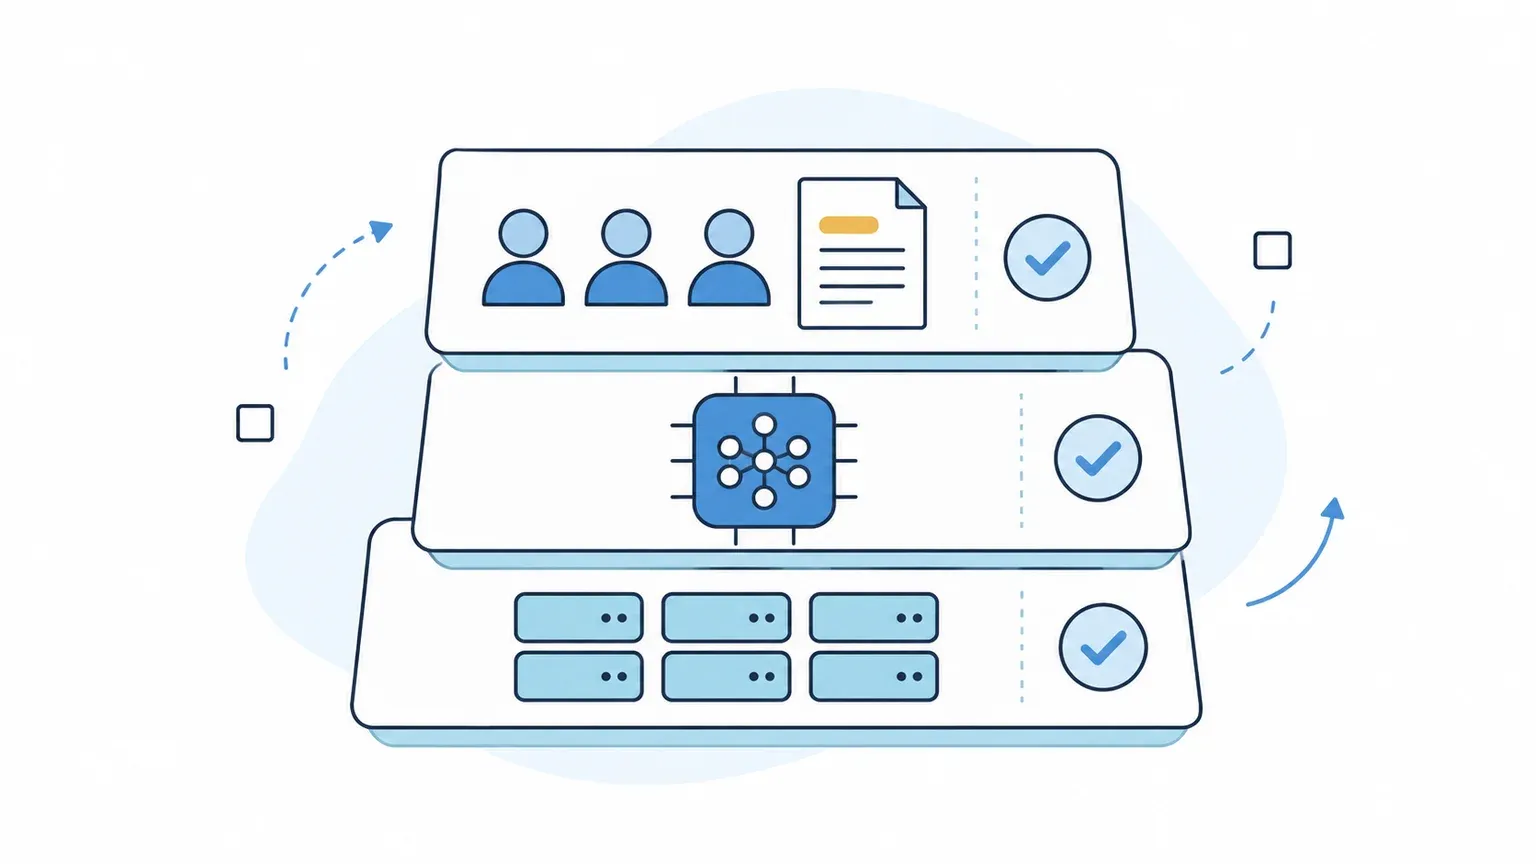
まず、言葉の範囲をそろえます。そのうえで、従来の脆弱性との違いと、誰が直すのかを、3つの層に分けて説明します。
「生成AIの脆弱性」が指す3つの意味
同じ「生成AI 脆弱性」という検索でも、別々の話題が混ざります。2026年10月23日にGoogleで検索すると、上位には、生成AIの支援でプログラミング言語PHPの脆弱性が見つかったという報道と、AIを使った脆弱性診断の解説が並んでいました。生成AIが持つ脆弱性を扱うページは、そのうちの一部です。意味は、次の3つに分かれます。
| 意味 | 例 | この記事での扱い |
|---|---|---|
| 生成AIを組み込んだシステムが持つ脆弱性 | 不正な指示で動作が変わる、機密情報が回答に出る、AIに与えた権限が悪用される | 中心に扱う |
| AIが見つける、他のソフトの脆弱性 | 生成AIの支援で、広く使われているソフトの欠陥が見つかる | 扱わない。AIを使った脆弱性診断と手動診断の違いの記事で説明している |
| AIが書いたコードの脆弱性 | 生成AIが出したプログラムに、欠陥が混ざる | 扱わない。開発の委託では別の確認が要る |
この記事では、以降の「生成AIの脆弱性」を、1つ目の意味で使います。自社で生成AIを使ったシステムを作る、または入れる立場の人が、発注の前に確認する範囲です。
従来の脆弱性とは直し方が違う
従来のソフトの脆弱性は、プログラムの欠陥として特定され、提供元が修正プログラムを出し、利用側が当てて直す、という流れが基本です。欠陥のある場所が分かれば、そこを直せます。
生成AIの弱点の中心は、これと性質が違います。OWASP Gen AI Security ProjectのLLMトップ10(2025年版)は、プロンプトインジェクション(AIへの指示に、不正な命令を混ぜる攻撃)の脆弱性を、モデルがプロンプトを処理する仕組みの中にあるものとして説明しています。人の目には見えない入力でも、モデルが読み取れば影響する、とも書かれています。さらに、外部の知識を足して回答の精度を上げるRAGや、追加の学習(ファインチューニング)を使っても、完全には軽減できないことが研究で示されている、と説明されています。
英国の国家サイバーセキュリティセンター(NCSC)も、プロンプトインジェクションは、SQLインジェクションのようには完全に緩和できないかもしれないと述べています。仕組みと理由は、プロンプトインジェクションとは何か、発注側の備えの記事で説明しています。
| 観点 | 従来のソフトの脆弱性 | 生成AIの弱点(モデルの性質に由来するもの) |
|---|---|---|
| 原因 | プログラムの欠陥 | モデルが、指示とデータを区別せず、文章として処理する性質 |
| 直し方 | 修正プログラムを当てる | 1か所を直して終わりにならず、権限の制限や人の承認などで、被害を小さくする設計にする |
| 直す人 | ソフトの提供元と、当てる利用側 | モデルの提供元、開発会社、自社の3者に分かれる |
| 確認の仕方 | 診断やスキャンで見つけ、修正後に再度確認する | 攻撃の入力を変えて試し、モデルや機能を変えるたびに、確認し直す |
| 残るリスク | 修正すれば、原則として解消する | 完全には消えないため、残るリスクを事業として受け入れるかを決める |
もう1つ、よくある思い込みがあります。AIの振る舞いを決める指示文(システムプロンプト)を秘密にしておけば安全、という考えです。OWASPは、システムプロンプトを秘密と考えるべきではなく、安全対策として使うべきでもない、と説明しています。認証情報のような機密は、そこに書いてはいけません。本当の問題は、指示文が見えることではなく、権限の確認をAIに任せていることや、機密を置いてはいけない場所に置いていることです。
3つの層に分けて誰が直すかを決める
生成AIを組み込んだシステムの脆弱性は、次の3つの層に分けると、誰が何を直すのかが決まります。OWASPの項目の番号は、あとで公式のページと照らすための目印です。
| 層 | 主な例(OWASPの項目) | 主に直す人 | 発注側が決めること |
|---|---|---|---|
| 周りのシステム | AIの出力を検証せずに後続へ渡し、XSSやSSRF、リモートコード実行につながる(LLM05)/従来のライブラリの脆弱性(LLM03) | 開発会社と運用担当 | 従来のWebシステムと同じ診断と更新を、委託の範囲に入れる |
| モデルの性質 | プロンプトインジェクション(LLM01)、もっともらしい誤情報(LLM09) | モデルの提供元と、開発会社の設計 | 完全には防げない前提で、被害を小さくする設計と承認を要件にする |
| データと権限の設計 | 機密情報の出すぎ(LLM02)、機能・権限・自律性の与えすぎ(LLM06)、RAGの検索データの混ざり(LLM08) | 自社が決め、開発会社が実装する | 渡すデータの範囲、利用者ごとの権限、AIに持たせる操作を決める |
1つ目の周りのシステムは、従来の脆弱性診断が使えます。2つ目のモデルの性質は、提供元の対応を待つだけでは足りず、設計で被害を小さくします。3つ目は、業務の中身を知っている自社でないと決められません。私の見立てでは、心配なのは、「AIの話だから」と開発会社に任せきりにして、3つ目を誰も決めないまま、納品を迎える形です。
生成AIの脆弱性に備えるため開発会社に確認すること
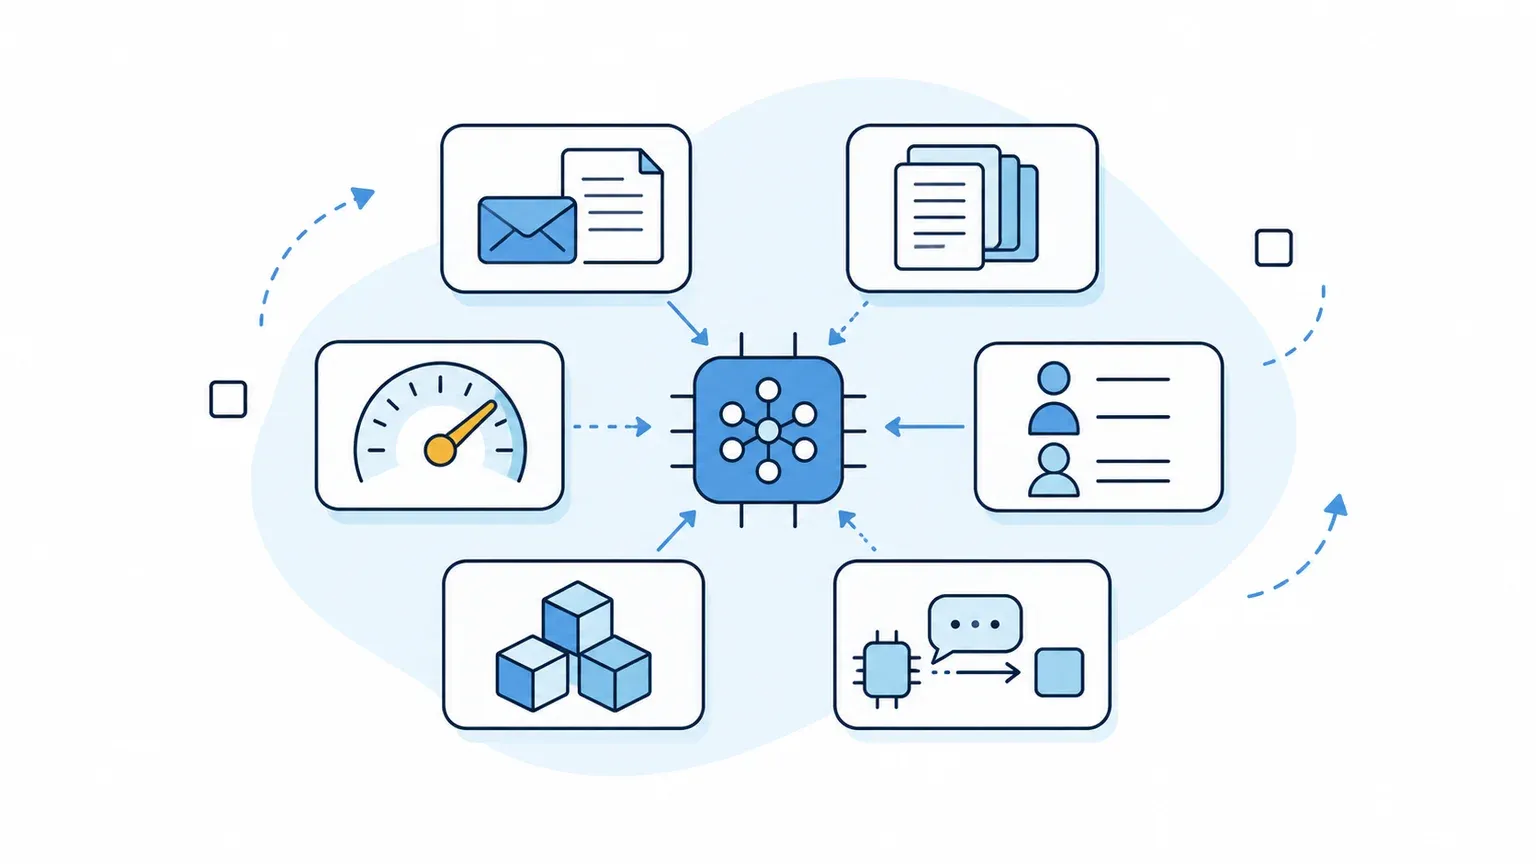
ここからは、LLM特有のリスクを、発注側が決めることに置き換えます。確認の相手は、開発会社です。
LLM特有のリスクを6つの入口に整理
OWASPのトップ10は10項目あるため、そのまま確認表にすると、何から聞くかで迷います。発注側が決めることに合わせて、6つの入口にまとめると、次のようになります。この6つの分け方は、OWASPの項目を私がまとめ直したもので、OWASPが示した分類ではありません。
| 入口 | 起きること | OWASPの項目 | 発注側が決めること |
|---|---|---|---|
| 指示の乗っ取り | AIが読む文書やWebページの中の命令に従い、意図しない動作をする | LLM01 | AIに持たせる操作と、人の承認が要る操作 |
| 情報の出すぎ | 機密情報や、他の利用者の情報が、回答に含まれる | LLM02・LLM07・LLM08 | AIに渡すデータの範囲と、利用者ごとの閲覧権限 |
| 権限の与えすぎ | 不要な機能や権限をAIが持ち、削除や送信などが起きる | LLM06 | 権限の最小化と、削除・送信の承認 |
| 出力の扱い | AIの出力を検証せずに後続のシステムへ渡し、不正な動作につながる | LLM05 | 出力の検証と無害化を、誰が、どこで行うか |
| 部品とデータの出どころ | 外部のモデルやライブラリ、学習データが改ざんされる。更新が止まったモデルを使い続ける | LLM03・LLM04 | 使うモデルとライブラリの一覧、更新と入れ替えの方針 |
| 誤情報と使いすぎ | もっともらしい誤りを出す。利用が急に増え、停止や費用の増加が起きる | LLM09・LLM10 | 出力の確認の手順と、利用量の上限と通知 |
3つ目の「権限の与えすぎ」について、OWASPは、根本の原因を、過剰な機能、過剰な権限、過剰な自律性のいずれかだと説明しています。たとえば、文書を読むだけのAIに、書き換えや削除ができる権限まで渡してしまう場合です。不正な指示が混ざったときに、被害の大きさを決めるのは、この権限です。
6つ目は、情報漏えいとは性質が違うため、後回しにされがちです。OWASPは、利用量に上限がないと、サービスの停止、経済的な損失、モデルの複製などにつながると説明しています。見積もりの段階で、利用が増えたときの費用の上限を決めておくと、運用が始まってから困らずに済みます。
納品後も続ける確認の仕組み
生成AIの脆弱性は、システムを納品した時点の確認だけでは足りません。理由は2つあります。1つは、モデルが更新されたり入れ替わったりすると、挙動が変わることです。OWASPは、モデルは中身を確かめにくい黒い箱で、公開されたソースコードのように、中を見て安全を確かめることはできないと説明しています。もう1つは、外部の文書や、ほかのシステムとの連携が増えるたびに、先の6つの入口のどれかが変わることです。
そのため、納品後の確認の仕組みを、次の4点について決めておきます。
- モデルや機能を変えるときの、再確認の範囲と、費用の負担
- AIの入力、出力、実行した操作の記録(ログ)の保存期間と、誰が見るか
- 想定外の動作を見つけたときの連絡先と、AIを止める判断ができる人
- 提供元のモデルが更新、廃止されるときの通知の受け方
診断で確かめる場合は、従来の診断の対象に、AI特有の入口まで入っているかを、頼む前に確かめます。診断の項目と、外注先の見極め方は、生成AIのセキュリティ診断の検査項目と外注先の選び方の記事で説明しています。
開発会社に確認する7項目
見積もりと提案の段階で、次の7項目を、開発会社に書面で確認してください。答えを口頭で聞くだけにせず、成果物として、書面で受け取る形にしておくと、担当が代わっても引き継げます。
- 生成AIがアクセスできるデータの一覧と、利用者ごとの閲覧権限との対応
- AIが実行できる操作(検索、送信、更新、削除など)の一覧と、人の承認が要る操作
- AIが外部から読む情報(メール、PDF、Webページ、社内の文書)の出どころと、その扱い
- AIの出力を、後続のシステムへ渡す前に検証し、無害化する仕組み
- 使うモデル、ライブラリ、学習や参照のデータの一覧と、更新と入れ替えの方針
- 想定する攻撃の種類と、テストの方法、結果を再現できる形で受け取ること
- 納品後のログ、再確認の範囲、費用の負担、事故が起きたときの連絡
開発会社から「このAIは安全です」「プロンプトインジェクションは防げます」と説明されたときは、どの入口に対して、どんな前提で防げるのかを、書面にしてもらってください。OWASPとNCSCは、完全には防げない可能性を示しているため、条件のない「防げる」は、そのまま受け取れません。あわせて、7項目のうち、費用が別になるもの(再確認、ログの確認など)を、見積もりの段階で聞いておくと、納品後に追加の請求を受けずに済みます。
よくある質問
- Q. 生成AIの脆弱性は、新しいモデルに替えれば解消しますか?
- A. 解消するとは言えません。OWASPは、プロンプトインジェクションについて、RAGや追加の学習を使っても完全には軽減できないと説明しています。モデルを替えると挙動が変わるため、替えるたびに確認し直す必要があります。
- Q. ChatGPTなどの既製のサービスを使うだけでも、自社で備えることはありますか?
- A. あります。サービス自体の欠陥は提供元が直しますが、何を入力するか、誰がどのデータを共有するか、外部のサービスとの連携をどこまで許すかは、使う自社が決めます。これは、先の3つの層のうち、データと権限の設計にあたります。
- Q. 従来のWebの脆弱性診断を受けていれば、足りますか?
- A. 足りない部分があります。従来の診断が得意なのは、周りのシステムです。AI特有の入口は、攻撃の入力を変えて試す確認が別に要ります。診断を頼む前に、AIの入口が対象に入っているかを確かめてください。